主题切换
15.1 宏观因子模型
名词解释:宏观因子(Macroeconomic Factors)
宏观因子是可观测或可估计的宏观经济驱动变量,对多种资产类别的收益率具有系统性解释力。与风格因子(如价值、动量)不同,宏观因子基于经济基本面,如GDP增长、通胀、利率和汇率,能够跨越资产类别解释风险和收益的来源。
一、主要宏观因子体系
1.1 五大核心宏观因子
现代宏观量化投资通常围绕五个核心因子构建框架:
| 因子 | 代理变量 | 经济含义 | 影响资产 |
|---|---|---|---|
| 增长(Growth) | PMI、工业增加值、GDP增速 | 经济扩张/收缩 | 权益、信用债、商品 |
| 通胀(Inflation) | CPI、PCE、BEI | 物价水平变化 | 名义国债、TIPS、黄金 |
| 利率(Rates) | 国债收益率、收益率曲线斜率 | 货币政策和融资条件 | 债券、REITs、成长股 |
| 汇率(FX) | DXY、贸易加权汇率 | 国际竞争力与资本流动 | 出口企业股、新兴市场 |
| 风险偏好(Risk Appetite) | VIX、信用利差、EMB利差 | 投资者情绪与风险承受 | 高收益债、权益、避险资产 |
1.2 因子的构建方法
宏观因子不能直接观测,需要通过统计方法从可观测的经济指标中提取。三种主流方法:
- 主成分分析(PCA):从多维经济数据中提取正交的主成分作为因子
- 卡尔曼滤波:将可观测经济变量与不可观测的潜在因子连接
- 动态因子模型(DFM):假设少量潜在因子驱动大量经济序列
此处有展示代码展开 ▼
python
import numpy as np
import pandas as pd
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler
import matplotlib.pyplot as plt

def build_macro_factors_pca(economic_data: pd.DataFrame,
                              n_factors: int = 5) -> tuple:
    """
    通过PCA从经济数据中提取宏观因子。

    参数:
        economic_data: 经济指标DataFrame,行=时间,列=指标
        n_factors: 提取的主成分数量
    返回:
        (factors, loadings, explained_variance)
    """
    # 标准化
    scaler = StandardScaler()
    data_scaled = scaler.fit_transform(economic_data)

    # PCA
    pca = PCA(n_components=n_factors)
    factors = pca.fit_transform(data_scaled)

    # 因子载荷
    loadings = pd.DataFrame(
        pca.components_.T,
        index=economic_data.columns,
        columns=[f'Factor{i+1}' for i in range(n_factors)]
    )

    # 解释方差
    explained_variance = pca.explained_variance_ratio_

    # 命名因子(基于最大载荷的经济指标)
    factor_names = []
    for i in range(n_factors):
        top_indicator = loadings[f'Factor{i+1}'].abs().idxmax()
        factor_names.append(f'PC{i+1} ({top_indicator})')

    factors_df = pd.DataFrame(
        factors,
        index=economic_data.index,
        columns=factor_names
    )

    # 可视化
    fig, axes = plt.subplots(2, 2, figsize=(14, 10))

    # 解释方差
    axes[0, 0].bar(range(1, n_factors + 1),
                   explained_variance * 100, color='steelblue')
    axes[0, 0].plot(range(1, n_factors + 1),
                    np.cumsum(explained_variance) * 100,
                    'ro-', markersize=8)
    axes[0, 0].set_xlabel('主成分')
    axes[0, 0].set_ylabel('解释方差 (%)')
    axes[0, 0].set_title('各主成分解释方差')
    axes[0, 0].grid(True, alpha=0.3)

    # 载荷热力图(前两个因子)
    load_top = loadings.iloc[:, :2].copy()
    load_top = load_top.loc[load_top.abs().sum(axis=1).sort_values(
        ascending=False).index[:15]]

    im = axes[0, 1].imshow(load_top.values, cmap='RdBu_r', aspect='auto',
                           vmin=-1, vmax=1)
    axes[0, 1].set_xticks(range(2))
    axes[0, 1].set_xticklabels(load_top.columns)
    axes[0, 1].set_yticks(range(len(load_top)))
    axes[0, 1].set_yticklabels(load_top.index, fontsize=8)
    axes[0, 1].set_title('前两个因子的载荷')
    plt.colorbar(im, ax=axes[0, 1])

    # 因子时序
    for i, col in enumerate(factors_df.columns[:2]):
        axes[1, i].plot(factors_df.index, factors_df[col],
                        linewidth=1, color=['darkblue', 'darkred'][i])
        axes[1, i].axhline(y=0, color='gray', linestyle='--', alpha=0.5)
        axes[1, i].set_title(col)
        axes[1, i].grid(True, alpha=0.3)

    plt.tight_layout()
    plt.show()

    return factors_df, loadings, explained_variance

# ===== 合成数据最小示例(数据为模拟,机制真实)=====
np.random.seed(42)
_demo_dates = pd.date_range('2015-01-31', periods=120, freq='ME')
_demo_growth = np.cumsum(np.random.randn(120) * 0.3)
_demo_infl = 2 + np.cumsum(np.random.randn(120) * 0.2)
_economic_data = pd.DataFrame({
    '工业增加值同比': 6 + _demo_growth * 0.5 + np.random.randn(120) * 0.3,
    'CPI同比': _demo_infl + np.random.randn(120) * 0.1,
    'PPI同比': _demo_infl * 1.2 - 1 + np.random.randn(120) * 0.5,
    '社融存量同比': 10 + _demo_growth * 0.4 + np.random.randn(120) * 0.4,
    'PMI': 50 + _demo_growth * 0.8 + np.random.randn(120) * 0.5,
    '出口同比': 5 + _demo_growth * 1.2 + np.random.randn(120) * 1.5,
}, index=_demo_dates)
_factors_df, _loadings, _ev = build_macro_factors_pca(_economic_data, n_factors=3)
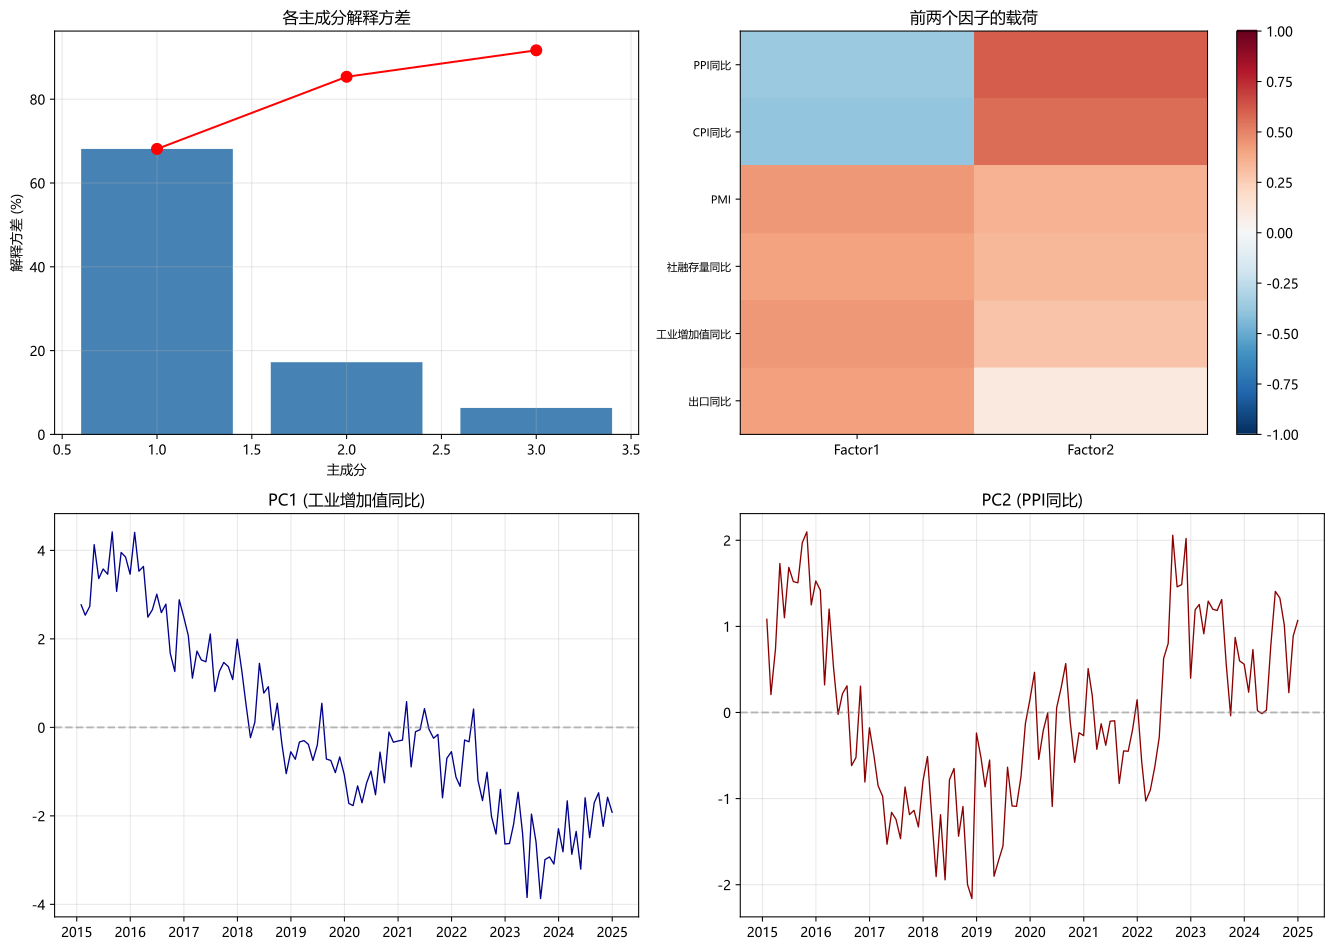
print('解释方差比:', np.round(_ev, 3))点击展开可浏览运行结果
解释方差比: [0.681 0.172 0.063]
二、因子暴露与资产收益回归
2.1 宏观因子模型的回归设定
将资产收益率对宏观因子进行时间序列回归:
其中
2.2 两阶段估计法(Fama-MacBeth)
此处有展示代码展开 ▼
python
import numpy as np
import pandas as pd

def fama_macbeth_macro(asset_returns: pd.DataFrame,
                        macro_factors: pd.DataFrame,
                        n_lags: int = 0) -> dict:
    """
    Fama-MacBeth 两阶段回归估计宏观因子风险溢价。

    第一阶段:对每个资产做时间序列回归得到 β
    第二阶段:每期横截面回归得到因子风险溢价 λ

    参数:
        asset_returns: (T, N) 资产超额收益率
        macro_factors: (T, K) 宏观因子时间序列
        n_lags: 滞后因子数(用于考虑延迟反应)
    返回:
        包含 betas, risk_premia, t_stats 的字典
    """
    T, N = asset_returns.shape
    K = macro_factors.shape[1]

    # 第一阶段:时间序列回归 (每个资产)
    betas = np.zeros((N, K))
    for i in range(N):
        y = asset_returns.iloc[:, i].values
        X = macro_factors.values
        X = np.column_stack([np.ones(len(X)), X])  # 添加截距

        beta = np.linalg.lstsq(X, y, rcond=None)[0]
        betas[i] = beta[1:]  # 斜率为因子暴露

    # 第二阶段:横截面回归 (每期)
    risk_premia = np.zeros((T, K))
    for t in range(T):
        y = asset_returns.iloc[t].values  # 横截面收益率
        X = betas  # 因子暴露作为解释变量
        X = np.column_stack([np.ones(N), X])

        premia = np.linalg.lstsq(X, y, rcond=None)[0]
        risk_premia[t] = premia[1:]

    # 风险溢价统计
    mean_premia = np.mean(risk_premia, axis=0)
    se_premia = np.std(risk_premia, axis=0) / np.sqrt(T)
    t_stats = mean_premia / se_premia

    # 显著性检验 (Newey-West adjusted)
    from statsmodels.tsa.stattools import adfuller

    return {
        'betas': pd.DataFrame(betas,
                               index=asset_returns.columns,
                               columns=[f'Beta_F{i+1}' for i in range(K)]),
        'risk_premia_annual': mean_premia * 12,
        't_stats': t_stats,
        'significant': np.abs(t_stats) > 1.96,
        'premia_time_series': pd.DataFrame(
            risk_premia,
            index=asset_returns.index,
            columns=[f'Lambda_F{i+1}' for i in range(K)]
        )
    }

# ===== 合成数据最小示例(数据为模拟,机制真实)=====
np.random.seed(7)
_dates = pd.date_range('2018-01-31', periods=60, freq='ME')
_macro = pd.DataFrame({
    '增长': np.random.randn(60).cumsum() * 0.2,
    '通胀': np.random.randn(60).cumsum() * 0.15,
    '利率': np.random.randn(60).cumsum() * 0.25,
}, index=_dates)
_betas = np.random.uniform(-0.5, 1.5, size=(3, 8))
_asset = pd.DataFrame(
    _macro.values @ _betas / 12 + np.random.randn(60, 8) * 0.03,
    columns=[f'资产{i+1}' for i in range(8)], index=_dates)
_res = fama_macbeth_macro(_asset, _macro)
for _k, _v in _res.items():
    print(f'--- {_k} ---')
print(_v.head() if hasattr(_v, 'head') else _v)点击展开可浏览运行结果
--- betas ---
      Beta_F1   Beta_F2   Beta_F3
资产1  0.099023  0.103908  0.041930
资产2 -0.022987  0.019075  0.034577
资产3  0.069511  0.110715  0.115734
资产4  0.052924  0.117291 -0.027789
资产5  0.007859 -0.025685  0.052240
--- risk_premia_annual ---
[ -5.01601926   1.53407342 -18.33657823]
--- t_stats ---
[ -5.64885807   1.77154588 -10.33948612]
--- significant ---
[ True False  True]
--- premia_time_series ---
            Lambda_F1  Lambda_F2  Lambda_F3
2018-01-31   0.052290   0.412745  -0.437124
2018-02-28   0.156476  -0.217130  -0.477258
2018-03-31   0.094631  -0.111593  -0.175279
2018-04-30   0.166772  -0.120862  -0.135752
2018-05-31   0.520955  -0.353570  -0.140635
三、宏观因子与风格因子的交互
3.1 因子轮动的宏观驱动
风格因子(价值、动量、质量、规模、低波动)的表现与宏观经济环境密切相关:
| 宏观环境 | 表现优异的风格因子 | 表现较差的风格因子 |
|---|---|---|
| 高增长 + 低通胀(Goldilocks) | 动量、成长 | 低波动、价值 |
| 衰退 + 通缩 | 质量、低波动 | 价值、小盘 |
| 滞胀 | 价值、商品因子 | 成长、动量 |
| 复苏 | 小盘、价值 | 低波动、质量 |
3.2 双因子暴露分析
此处有展示代码展开 ▼
python
def factor_interaction_analysis(asset_returns: pd.DataFrame,
                                 macro_factors: pd.DataFrame,
                                 style_factors: pd.DataFrame) -> pd.DataFrame:
    """
    分析宏观因子与风格因子的交互效应。

    回归: r_i = α + β_macro * F_macro + β_style * F_style
               + γ * (F_macro * F_style) + ε

    参数:
        asset_returns: 资产收益率
        macro_factors: 宏观因子
        style_factors: 风格因子
    返回:
        交互项效应的DataFrame
    """
    results = []

    for macro_name in macro_factors.columns:
        for style_name in style_factors.columns:
            # 构造回归变量
            F_macro = macro_factors[macro_name].values
            F_style = style_factors[style_name].values
            F_interact = F_macro * F_style

            # 对每个资产做回归
            interaction_betas = []

            for asset in asset_returns.columns:
                y = asset_returns[asset].values
                X = np.column_stack([
                    np.ones(len(y)), F_macro, F_style, F_interact
                ])

                # 移除包含NaN的行
                mask = ~np.isnan(y) & ~np.isnan(X).any(axis=1)
                if mask.sum() < 10:
                    continue

                beta = np.linalg.lstsq(X[mask], y[mask], rcond=None)[0]
                interaction_betas.append(beta[3])  # 交互项系数

            if interaction_betas:
                mean_beta = np.mean(interaction_betas)
                t_stat = mean_beta / (np.std(interaction_betas) /
                                      np.sqrt(len(interaction_betas)))

                results.append({
                    'Macro_Factor': macro_name,
                    'Style_Factor': style_name,
                    'Interaction_Beta_mean': mean_beta,
                    't_stat': t_stat,
                    'Significant': abs(t_stat) > 1.96
                })

    return pd.DataFrame(results)

# ===== 合成数据最小示例(数据为模拟,机制真实)=====
np.random.seed(11)
_idx = pd.date_range('2018-01-31', periods=60, freq='ME')
_ar = pd.DataFrame(np.random.randn(60, 5) * 0.02,
                   columns=[f'资产{i+1}' for i in range(5)], index=_idx)
_mf = pd.DataFrame({'增长': np.random.randn(60), '通胀': np.random.randn(60)}, index=_idx)
_sf = pd.DataFrame({'动量': np.random.randn(60), '价值': np.random.randn(60), '低波': np.random.randn(60)}, index=_idx)
_int_res = factor_interaction_analysis(_ar, _mf, _sf)
print(_int_res.head(10))点击展开可浏览运行结果
Macro_Factor Style_Factor  Interaction_Beta_mean    t_stat  Significant
0           增长           动量               0.000093  0.132583        False
1           增长           价值               0.000876  0.553598        False
2           增长           低波              -0.001020 -0.976970        False
3           通胀           动量               0.000752  0.685998        False
4           通胀           价值               0.000490  0.359032        False
5           通胀           低波               0.000543  0.562150        False
四、因子择时框架
4.1 因子择时的逻辑
因子择时(Factor Timing)是基于宏观经济状态动态调整因子配置的策略。其基本逻辑是:不同因子在不同宏观环境下表现不同,通过预测宏观状态可以间接预测因子收益。
4.2 基于宏观状态的因子轮动
此处有展示代码展开 ▼
python
def macro_regime_factor_allocation(macro_state: str,
                                    factor_universe: dict) -> dict:
    """
    基于宏观状态的因子配置权重。

    参数:
        macro_state: 宏观状态标签
            - 'expansion': 扩张期
            - 'contraction': 收缩期
            - 'stagflation': 滞胀期
            - 'recovery': 复苏期
        factor_universe: 因子名称到中性权重的映射
    返回:
        调整后的因子权重
    """
    # 宏观状态与因子表现的关系矩阵
    regime_tilts = {
        'expansion': {'momentum': 1.5, 'growth': 1.5, 'quality': 1.0,
                       'value': 0.5, 'low_vol': 0.5, 'size': 1.0},
        'contraction': {'momentum': 0.5, 'growth': 0.3, 'quality': 2.0,
                         'value': 0.8, 'low_vol': 2.0, 'size': 0.2},
        'stagflation': {'momentum': 0.5, 'growth': 0.2, 'quality': 1.0,
                         'value': 1.5, 'low_vol': 1.0, 'size': 0.5},
        'recovery': {'momentum': 1.0, 'growth': 1.2, 'quality': 1.0,
                      'value': 1.5, 'low_vol': 0.5, 'size': 1.8}
    }

    if macro_state not in regime_tilts:
        return factor_universe  # 未知状态,保持中性

    tilts = regime_tilts[macro_state]

    # 计算调整后的权重
    adjusted_weights = {}
    for factor, neutral_weight in factor_universe.items():
        tilt = tilts.get(factor, 1.0)
        adjusted_weights[factor] = neutral_weight * tilt

    # 归一化
    total = sum(adjusted_weights.values())
    adjusted_weights = {k: v / total for k, v in adjusted_weights.items()}

    return adjusted_weights

# ===== 合成数据最小示例(数据为模拟,机制真实)=====
_universe = {'momentum': 0.2, 'growth': 0.2, 'quality': 0.2, 'value': 0.2, 'low_vol': 0.2}
for _state in ['expansion', 'contraction', 'stagflation', 'recovery']:
    _w = macro_regime_factor_allocation(_state, _universe)
print(_state, '->', {k: round(v, 3) for k, v in _w.items()})点击展开可浏览运行结果
expansion -> {'momentum': 0.3, 'growth': 0.3, 'quality': 0.2, 'value': 0.1, 'low_vol': 0.1}
contraction -> {'momentum': 0.089, 'growth': 0.054, 'quality': 0.357, 'value': 0.143, 'low_vol': 0.357}
stagflation -> {'momentum': 0.119, 'growth': 0.048, 'quality': 0.238, 'value': 0.357, 'low_vol': 0.238}
recovery -> {'momentum': 0.192, 'growth': 0.231, 'quality': 0.192, 'value': 0.288, 'low_vol': 0.096}宏观因子模型为量化投资提供了一个自上而下的风险归因和资产配置框架。在掌握了宏观因子的构建与应用之后,我们将深入探讨一个最为重要的宏观经济变量——美联储货币政策——如何影响全球资产定价。
常见误区
误区1:用最新修正确的宏观数据回测。 GDP/CPI 等数据发布后会多次修正,直接用终值会造成前视偏差。严格做法是用发布时点的 vintage 数据。
误区2:因子暴露用全样本回归。 宏观暴露是时变的(企业套保、债务结构都会变),全样本回归会平均掉关键信息,应使用滚动窗口或状态切换模型。
误区3:把宏观因子和风格因子混为一谈。 久期因子(利率敏感)与价值/动量等风格因子方向可能阶段性相反,混淆会低估组合的真实宏观暴露。
误区4:把相关性当因果。 油价上涨可能反映需求(增长)也可能反映供给收缩(滞胀),对资产的含义完全相反。
本章要点
- 增长、通胀、利率、信用、美元是宏观因子体系的五大主轴
- 因子暴露回归必须使用滚动窗口,并对数据发布时点做 vintage 处理
- 宏观因子与风格因子存在交互效应,组合需同时报告两层暴露
- 因子择时的有效性依赖对周期位置的正确识别,而非单期数据